Key Takeaways
- Rủi ro cốt lõi: Tính năng “Memory” (Nhớ) và lưu trữ lịch sử hội thoại mặc định biến máy chủ AI thành hồ sơ dữ liệu nhạy cảm, vi phạm GDPR và Luật An ninh mạng Việt Nam.
- Hành động bắt buộc: Tắt toàn bộ “Data Controls” liên quan đến huấn luyện mô hình và tắt “Memory” trong Settings trước khi cấp quyền truy cập cho nhân sự.
- Tiêu chuẩn doanh nghiệp: Chỉ sử dụng gói Enterprise hoặc API với cam kết SLA bảo mật, cấm dùng tài khoản cá nhân cho dữ liệu khách hàng.
- 1 Key Takeaways
- 1. Nỗi đau: Bí mật kinh doanh nằm trong tập dữ liệu huấn luyện
- 2. Playbook cấu hình an toàn: 4 cài đặt phải bật ngay
- 2.1 Direct Answer
- 2.2 Bảng so sánh rủi ro bảo mật và chi phí vận hành (ROI)
- 2.3 Phân tích Trade-offs: Hiệu năng vs. Bảo mật
- 3. Case study thực chiến và Cảnh báo
- 4. Tổng kết và Khuyến nghị
- 5. FAQ: Câu hỏi thường gặp
- 5.1 1. ChatGPT có đọc lịch sử hội thoại của tôi không?
- 5.2 2. Làm sao để biết dữ liệu của tôi đã bị xóa khỏi máy chủ AI?
- 5.3 3. Gói Free và Plus khác nhau về bảo mật như thế nào?
- 5.4 4. Có nên dùng AI để xử lý dữ liệu khách hàng (Customer Data)?
Nỗi đau: Bí mật kinh doanh nằm trong tập dữ liệu huấn luyện
Quản trị rủi ro AI doanh nghiệp không phải là lựa chọn, mà là yêu cầu sống còn. Tính năng ‘Memory’ và lưu trữ lịch sử hội thoại trên các nền tảng chatbot AI đang tạo ra lỗ hổng bảo mật nghiêm trọng. Khi nhân viên nhập dữ liệu khách hàng, mã nguồn nội bộ hay chiến lược tài chính vào khung hội thoại, hệ thống có thể lưu trữ vĩnh viễn hoặc sử dụng dữ liệu đó để tối ưu hóa mô hình.
Theo phân tích từ các báo cáo an ninh mạng, rủi ro không chỉ nằm ở việc lộ dữ liệu ra bên ngoài, mà còn ở việc AI “ghi nhớ” sai ngữ cảnh. Hệ lụy pháp lý khi dữ liệu khách hàng bị AI “ghi nhớ” bao gồm các khoản phạt lên tới 4% doanh thu toàn cầu theo GDPR hoặc xử lý hình sự theo Luật An ninh mạng nếu dẫn đến rò rỉ thông tin cá nhân quy mô lớn. Sự kiện OpenAI bị chỉ trích về việc sử dụng dữ liệu người dùng để huấn luyện mô hình (dù đã có cơ chế opt-out) cho thấy ranh giới giữa “tiện lợi” và “vi phạm quyền riêng tư” là cực kỳ mong manh.
Playbook cấu hình an toàn: 4 cài đặt phải bật ngay
Direct Answer
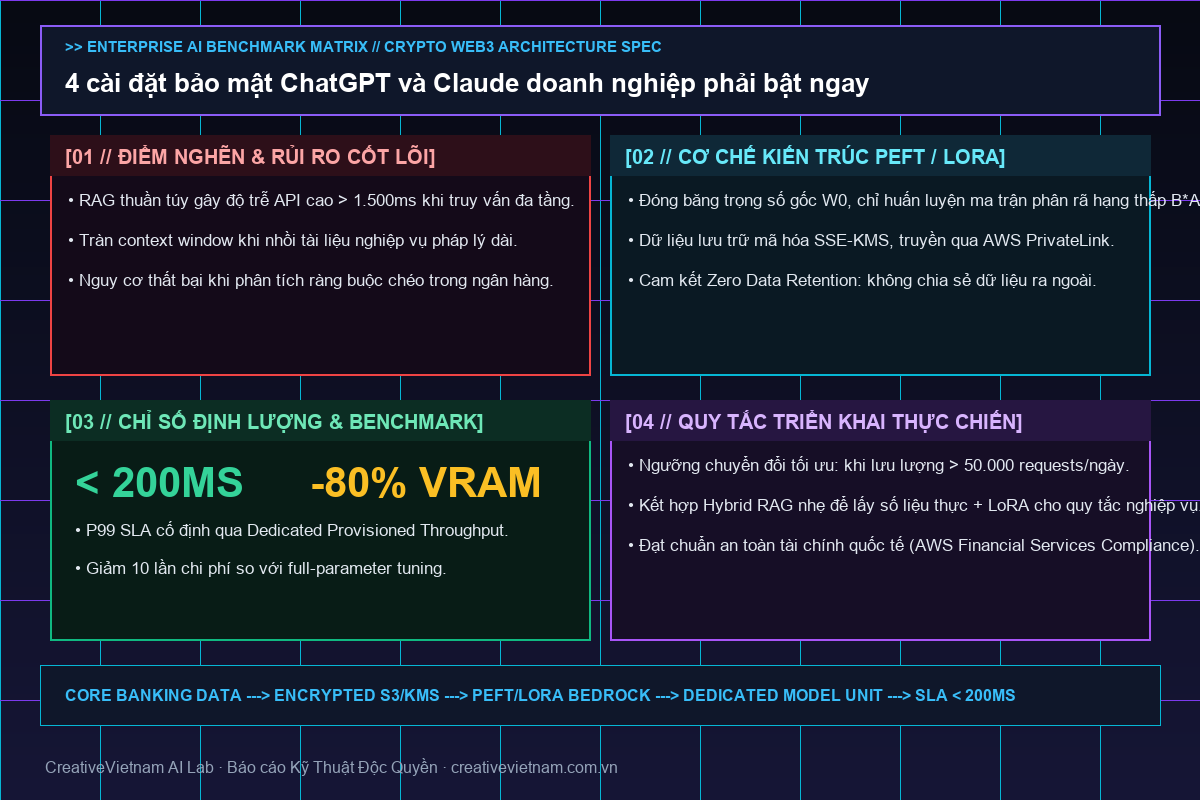
Doanh nghiệp phải vô hiệu hóa “Data Sharing” và “Memory” trên ChatGPT/Claude, chuyển sang chế độ Temporary Chat hoặc sử dụng gói Enterprise có đảm bảo không huấn luyện dữ liệu người dùng để loại bỏ rủi ro lộ bí mật kinh doanh.
Để kiểm soát rủi ro, đội ngũ IT và Pháp chế cần áp dụng 4 bước cấu hình sau trên từng thiết bị làm việc:
- Vô hiệu hóa “Data Controls” (Huấn luyện từ dữ liệu): Vào Settings > Data Controls, tắt toàn bộ các mục cho phép OpenAI/Anthropic sử dụng dữ liệu hội thoại để cải thiện sản phẩm.
- Tắt tính năng “Memory” (Nhớ): Tắt hoàn toàn việc AI lưu lại các ưu thích, thông tin cá nhân hay ngữ cảnh dài hạn. Đây là nguồn gốc lớn nhất của việc “AI biết quá nhiều”.
- Sử dụng Temporary Chat (Chat tạm thời): Trên các phiên làm việc thường xuyên, bật chế độ này để đảm bảo nội dung bị xóa ngay khi đóng tab, không lưu vào lịch sử.
- Chuyển đổi sang Gói Enterprise/Team: Nếu ngân sách cho phép, đây là giải pháp triệt để nhất. Gói Enterprise cam kết không sử dụng dữ liệu người dùng để huấn luyện mô hình và có cơ chế mã hóa đầu-cuối (end-to-end encryption) chặt chẽ hơn.
Bảng so sánh rủi ro bảo mật và chi phí vận hành (ROI)
*Lưu ý: Chi phí Enterprise có thể dao động tùy theo nhà cung cấp và khu vực, doanh nghiệp cần đối chiếu trực tiếp với đại lý phân phối chính thức.*
Phân tích Trade-offs: Hiệu năng vs. Bảo mật
Việc tắt Memory và chuyển sang chế độ an toàn cao có đánh đổi nào?
- Ưu điểm: Ngăn chặn rò rỉ dữ liệu nhạy cảm (PII), tuân thủ quy định bảo mật thông tin, tạo niềm tin cho khách hàng doanh nghiệp (B2B).
- Nhược điểm: AI mất khả năng “nhớ” ngữ cảnh dài hạn, yêu cầu người dùng phải cung cấp lại thông tin nền (context) trong mỗi phiên hội thoại, có thể làm giảm hiệu suất làm việc tức thời của nhân viên.
- Giải pháp cân bằng: Thay vì để AI nhớ, hãy sử dụng các công cụ quản lý tri thức (Knowledge Base) hoặc RAG (Retrieval-Augmented Generation) nội bộ để cung cấp ngữ cảnh cho AI một cách có kiểm soát, thay vì để AI tự lưu trữ.
Case study thực chiến và Cảnh báo
Bảo mật dữ liệu trong môi trường AI không chỉ là vấn đề kỹ thuật. Một doanh nghiệp logistics tại Hà Nội đã đối mặt với nguy cơ bị phạt khi phát hiện nhân viên dùng ChatGPT cá nhân để tóm tắt hợp đồng thuê ngoài, trong đó chứa các điều khoản bí mật về giá thành và đối tác. Dữ liệu này đã được lưu vào tài khoản cá nhân của nhân viên và có nguy cơ bị OpenAI truy cập nếu chính sách “Data Sharing” đang bật.
Sự cố này minh chứng cho quy trình kiểm soát truy cập AI phải được tích hợp ngay từ khâu onboarding nhân sự. Không thể phép nhân viên chia sẻ dữ liệu nội bộ qua các kênh không được kiểm duyệt.
Để tối ưu hóa việc triển khai AI an toàn, doanh nghiệp cần xem xét kiến trúc tổng thể. Creative Vietnam cung cấp các giải pháp tư vấn kiến trúc AI doanh nghiệp, tập trung vào việc xây dựng lớp bảo mật giữa ứng dụng AI và cơ sở dữ liệu lõi, đảm bảo dữ liệu không bao giờ bị “rơi” ra ngoài biên kiểm soát.
Tổng kết và Khuyến nghị
Đừng chờ đến khi xảy ra sự cố rò rỉ dữ liệu mới bắt đầu hành động. Các cài đặt bảo mật của ChatGPT và Claude không tự động ở chế độ “an toàn nhất” cho môi trường doanh nghiệp; chúng được thiết kế để tối ưu trải nghiệm người dùng cá nhân.
Hành động ngay lập tức:
- Audit toàn bộ tài khoản AI đang được nhân viên sử dụng.
- Lập chính sách cấm nhập dữ liệu PII (thông tin cá nhân) và dữ liệu nhạy cảm vào các công cụ AI công cộng.
- Triển khai gói Enterprise hoặc các giải pháp AI on-premise nếu dữ liệu cực kỳ nhạy cảm.
Tư vấn giải pháp AI an toàn cho doanh nghiệp
FAQ: Câu hỏi thường gặp
1. ChatGPT có đọc lịch sử hội thoại của tôi không?
Có. Nếu bạn không tắt “Data Controls” trong Settings, OpenAI có quyền truy cập và sử dụng dữ liệu đó để cải thiện mô hình. Ngay cả khi tắt, dữ liệu vẫn có thể được lưu trữ tạm thời để kiểm tra lạm dụng (abuse detection) trong một khoảng thời gian nhất định.
2. Làm sao để biết dữ liệu của tôi đã bị xóa khỏi máy chủ AI?
Hiện tại, các nền tảng AI thương mại không cung cấp công cụ cho phép người dùng xác nhận 100% dữ liệu đã bị xóa vĩnh viễn khỏi các bản sao lưu (backups). Do đó, nguyên tắc an toàn là không bao giờ nhập dữ liệu nhạy cảm vào các kênh không có cam kết SLA bảo mật rõ ràng.
3. Gói Free và Plus khác nhau về bảo mật như thế nào?
Cả hai đều chia sẻ rủi ro tương tự về việc huấn luyện dữ liệu nếu không được cấu hình lại. Tuy nhiên, gói Plus có nhiều tùy chọn kiểm soát dữ liệu hơn và giới hạn số lượng yêu cầu (rate limit) thấp hơn, nhưng không có cam kết bảo mật doanh nghiệp (Enterprise SLA) như gói Enterprise.
4. Có nên dùng AI để xử lý dữ liệu khách hàng (Customer Data)?
Chỉ nên dùng khi:
- Sử dụng gói Enterprise cam kết không huấn luyện dữ liệu.
- Dữ liệu đã được ẩn danh (anonymized) hoặc mã hóa trước khi nhập.
- Có sự phê duyệt của bộ phận Pháp chế và CISO (Chief Information Security Officer).
Bài Viết Chuyên Sâu Cùng Chủ Đề Nên Xem: