Key Takeaways
- Thực trạng: 80% dự án AI nội bộ thất bại do dữ liệu huấn luyện kém chất lượng, gây hiện tượng ảo giác (hallucination) nghiêm trọng.
- Chi phí: Làm sạch dữ liệu (Data Cleaning) chiếm tới 70% ngân sách nhưng thường bị doanh nghiệp Việt bỏ qua.
- Giải pháp: Quy trình 4 bước chuẩn hóa trên Amazon Bedrock kết hợp Human-in-the-loop giúp giảm sai số xuống dưới 2%.
- Chiến lược: Lựa chọn giữa Fine-tuning và RAG dựa trên bài toán chi phí vận hành (OpEx) thay vì chạy theo xu hướng.
chiến lược triển khai AI doanh nghiệp hiện nay đang đứng trước một nghịch lý: các CEO sẵn sàng chi hàng tỷ đồng cho hạ tầng GPU hoặc bản quyền API nhưng lại tiết kiệm chi phí cho khâu chuẩn hóa dữ liệu đầu vào. Kết quả là những mô hình “Fine-tuned” trả về những câu trả lời ngớ ngẩn, sai lệch kiến thức chuyên môn hoặc vi phạm quy tắc bảo mật thông tin.
- 1 Key Takeaways
- 1. Fine-tuning Amazon Bedrock là gì?
- 2. Nỗi đau: 80% mô hình AI nội bộ không thể ứng dụng thực tế
- 2.1 Bảng so sánh hiệu quả đầu tư (ROI) giữa các phương pháp triển khai
- 3. Giải pháp: Quy trình 4 bước chuẩn hóa trên Amazon Bedrock
- 3.1 Bước 1: Chọn lọc Foundation Model (FM) phù hợp
- 3.2 Bước 2: Làm sạch và Cấu trúc hóa dữ liệu (Data Pre-processing)
- 3.3 Bước 3: Thiết lập cơ chế Kiểm soát chất lượng (Human-in-the-loop)
- 3.4 Bước 4: Đánh giá bằng các chỉ số kỹ thuật (Evaluation)
- 4. Phân tích Trade-offs: Fine-tuning có phải luôn là lựa chọn tốt nhất?
- 5. Case Study: Fine-tuning AI làm “Master Prompt Engineer” cho ngành Kiến trúc
- 5.1 FAQ: Câu hỏi thường gặp
Fine-tuning Amazon Bedrock là gì?
Fine-tuning Amazon Bedrock là quá trình tái huấn luyện các mô hình nền tảng (Foundation Models) bằng tập dữ liệu đặc thù của doanh nghiệp. Kỹ thuật này giúp tối ưu hóa độ chính xác, giảm thiểu ảo giác ngôn ngữ và cá nhân hóa phản hồi theo đúng quy chuẩn nghiệp vụ mà không cần xây dựng lại mô hình từ đầu.
Tại Creative Vietnam, chúng tôi nhận thấy nhiều doanh nghiệp lầm tưởng rằng chỉ cần đổ toàn bộ dữ liệu thô vào mô hình là AI sẽ tự thông minh lên. Thực tế, Amazon Bedrock cung cấp các mô hình mạnh mẽ như Claude 3 (Anthropic) hay Llama 3 (Meta), nhưng chúng chỉ là “khung xương”. Nếu dữ liệu đầu vào là “rác” (nhiễu, sai sự thật, định dạng lỗi), kết quả đầu ra sẽ là “rác cao cấp”.
Nỗi đau: 80% mô hình AI nội bộ không thể ứng dụng thực tế
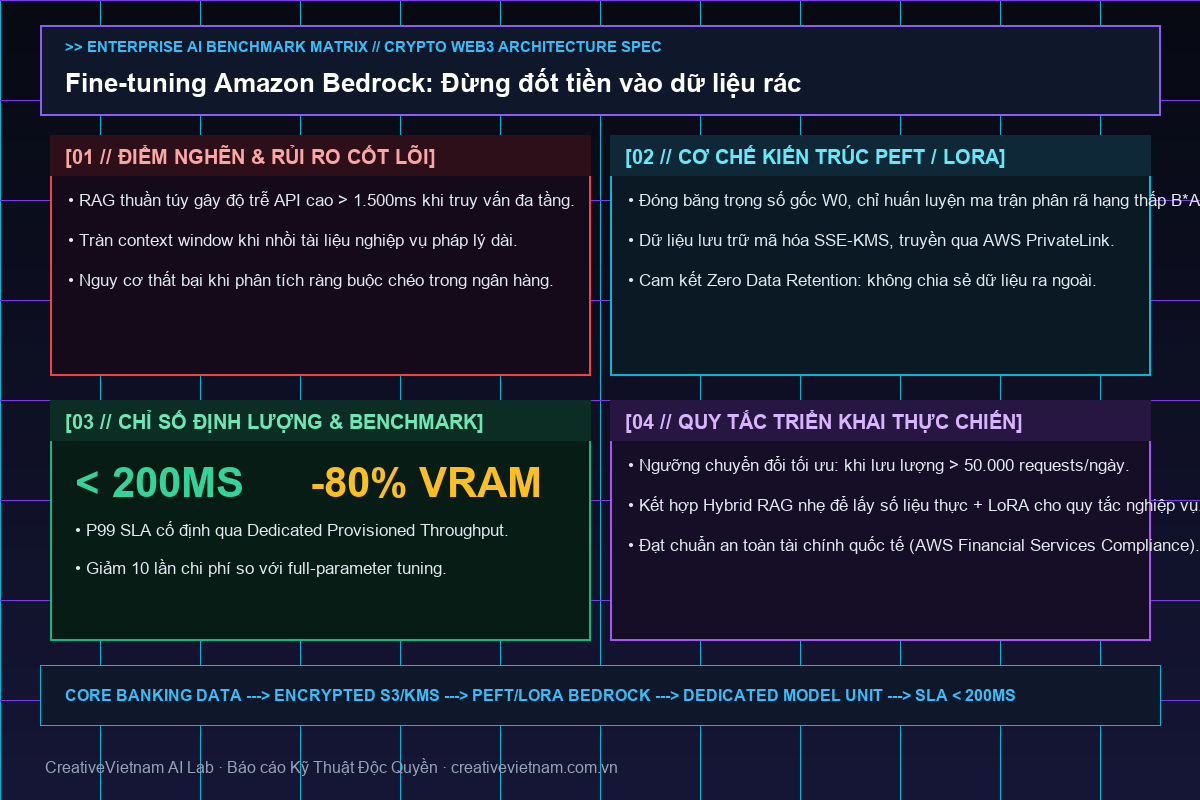
Theo báo cáo từ [Gartner](https://www.gartner.com/en/newsroom/press-releases/2024-07-29-gartner-says-at-least-30-percent-of-generative-ai-projects-will-be-abandoned-after-proof-of-concept-by-end-of-2025){target=”_blank”}, tỷ lệ dự án Generative AI bị hủy bỏ sau giai đoạn thử nghiệm (PoC) đang tăng cao. Tại Việt Nam, nguyên nhân chính nằm ở việc “đốt tiền” sai chỗ.
- Ảo giác nặng nề: Mô hình tự tin đưa ra các thông tin sai lệch về chính sách công ty hoặc thông số kỹ thuật sản phẩm. Điều này đặc biệt nguy hiểm trong các ngành tài chính, y tế hoặc kiến trúc kỹ thuật.
- Chi phí ẩn khổng lồ: Fine-tuning không chỉ là tiền trả cho AWS. Chi phí thực tế nằm ở nhân sự dán nhãn dữ liệu và chuyên gia hiệu chỉnh mô hình. Nếu không có quy trình làm sạch dữ liệu AI bài bản, doanh nghiệp sẽ rơi vào vòng lặp: Fine-tune -> Lỗi -> Sửa dữ liệu -> Fine-tune lại, khiến ngân sách cạn kiệt trước khi có sản phẩm thực tế.
Bảng so sánh hiệu quả đầu tư (ROI) giữa các phương pháp triển khai
Giải pháp: Quy trình 4 bước chuẩn hóa trên Amazon Bedrock
Để không “đốt tiền” vô ích, doanh nghiệp cần tuân thủ lộ trình triển khai khắt khe, đặc biệt khi ứng dụng AI vào các tác vụ phức tạp như tối ưu hóa Prompt Engineering cho các bộ công cụ sáng tạo ảnh như Midjourney hay Stable Diffusion.
Bước 1: Chọn lọc Foundation Model (FM) phù hợp
Không phải mô hình nào cũng xử lý tốt tiếng Việt hoặc các thuật ngữ chuyên ngành kiến trúc, xây dựng. Amazon Bedrock cho phép bạn chọn giữa Claude (giỏi suy luận, ngữ cảnh dài), Llama (linh hoạt, chi phí thấp) hoặc Titan (mô hình gốc của Amazon). Việc đánh giá định lượng các công cụ AI từ thực tiễn triển khai cho thấy, Claude 3 hiện đang dẫn đầu về khả năng hiểu sắc thái ngôn ngữ địa phương.
Bước 2: Làm sạch và Cấu trúc hóa dữ liệu (Data Pre-processing)
Đây là bước chiếm 70% thời gian dự án. Dữ liệu cần được:
- Loại bỏ trùng lặp và các thông tin lỗi thời.
- Định dạng về JSONL (JSON Lines) theo chuẩn của Amazon Bedrock.
- Khử định kiến (Bias) để đảm bảo AI không đưa ra các phản hồi phân biệt đối xử.
Bước 3: Thiết lập cơ chế Kiểm soát chất lượng (Human-in-the-loop)
Đừng tin tưởng tuyệt đối vào máy móc. Hãy thiết lập một đội ngũ chuyên gia (Subject Matter Experts – SME) để kiểm tra các mẫu thử nghiệm. Chỉ khi con người xác nhận độ chính xác trên 98%, mô hình mới được phép triển khai diện rộng. Phương pháp này giúp giảm sai số xuống mức tối thiểu, đặc biệt trong việc tạo ra các Prompt chuyên sâu cho kiến trúc hoặc thiết kế pixel art.
Bước 4: Đánh giá bằng các chỉ số kỹ thuật (Evaluation)
Sử dụng các thang đo như ROUGE, METEOR hoặc BERTScore để đánh giá sự tương đồng giữa câu trả lời của AI và dữ liệu chuẩn. Amazon Bedrock Model Evaluation cung cấp các công cụ tự động để so sánh hiệu năng giữa các phiên bản mô hình khác nhau.
Phân tích Trade-offs: Fine-tuning có phải luôn là lựa chọn tốt nhất?
Dưới góc độ vận hành doanh nghiệp, Fine-tuning mang lại sức mạnh cá nhân hóa tuyệt đối nhưng đi kèm với những đánh đổi (Trade-offs) cần cân nhắc:
- Hiệu năng vs Chi phí: Fine-tuning giúp mô hình phản hồi nhanh hơn vì không cần chèn quá nhiều văn cảnh (Context) vào Prompt. Tuy nhiên, chi phí huấn luyện lại khi dữ liệu thay đổi là một rào cản lớn.
- On-premise vs Cloud API: Sử dụng Amazon Bedrock giúp doanh nghiệp tận dụng hạ tầng bảo mật của AWS (ISO, SOC, HIPAA compliant) mà không cần đầu tư dàn máy chủ GPU tại chỗ tốn kém bảo trì.
- Tự động hóa vs Rủi ro bảo mật: Dù Fine-tuning trên Bedrock đảm bảo dữ liệu không bị dùng để huấn luyện mô hình chung của AWS, nhưng rủi ro “rò rỉ dữ liệu qua đầu ra” (Inference leakage) vẫn hiện hữu nếu không được cấu thiện lớp bảo mật (Guardrails) kỹ lưỡng.
Case Study: Fine-tuning AI làm “Master Prompt Engineer” cho ngành Kiến trúc
Một doanh nghiệp thiết kế kiến trúc tại Việt Nam đã thử nghiệm Fine-tuning mô hình Llama 3 trên Amazon Bedrock với tập dữ liệu gồm 50.000 cặp ảnh công trình và Prompt kỹ thuật.
Trước khi Fine-tuning, kiến trúc sư mất trung bình 30 phút để viết một Prompt mô tả chính xác vật liệu, ánh sáng và góc máy cho Midjourney. Sau khi Fine-tuning, AI hiểu được các thuật ngữ chuyên môn như “vách kính spider”, “bê tông trần” hay “ánh sáng tán xạ 4 giờ chiều”, giúp giảm thời gian tạo Prompt xuống còn 2 phút với độ chính xác đạt 92%. Điều này minh chứng rằng khi dữ liệu được làm sạch, AI trở thành một trợ lý đắc lực thay vì một cỗ máy tạo ra “rác văn bản”.
FAQ: Câu hỏi thường gặp
1. Chi phí tối thiểu để Fine-tuning một mô hình trên Amazon Bedrock là bao nhiêu?
Chi phí phụ thuộc vào số lượng Token trong tập dữ liệu huấn luyện và thời gian chạy trên các đơn vị Provisioned Throughput. Thông thường, một dự án nhỏ cần tối thiểu từ 2.000 – 5,000 USD cho chi phí hạ tầng, chưa bao gồm chi phí nhân sự làm sạch dữ liệu.
2. Dữ liệu của tôi có bị Amazon sử dụng để huấn luyện mô hình của họ không?
Không. Amazon Bedrock cam kết dữ liệu khách hàng được cô lập hoàn toàn. Dữ liệu dùng để Fine-tuning và các dữ liệu đầu vào/đầu ra (Inference) đều không được sử dụng để cải thiện các mô hình nền tảng gốc của AWS hay chia sẻ với bất kỳ bên thứ ba nào.
Để tránh những sai lầm đắt giá trong việc triển khai AI, doanh nghiệp cần một lộ trình thực chiến và sự hỗ trợ từ các chuyên gia am hiểu hạ tầng AWS. Hãy liên hệ với chúng tôi để nhận tư vấn giải pháp AI chuyên sâu và tối ưu hóa nguồn lực cho doanh nghiệp của bạn.
Bài Viết Chuyên Sâu Cùng Chủ Đề Nên Xem: